0
 2025-05-24 11:32:02
최근 발전에서 가장 많이 논의되는 요인: 모델에 휠씬 더 많은 연산력(컴퓨팅 자원)을 투입하는 것입니다.
많은 사람들은 이것이 단순히 무어의 법칙 때문이라고 생각합니다. 하지만 무어의 법칙이 전성기였던 과거에도 그 속도는 비교할 수 없이 더뎠습니다. 10년당 약 1~1.5 OOMs 정도였죠. 지금 우리가 목격하는 연산 능력의 증가 속도는 무어의 법칙보다 약 5배 빠른 수준인데, 이는 막대한 투자 때문입니다. (과거에는 단일 모델에 100만 달러를 쓰는 것은 터무니없는 생각이었지만, 지금은 푼돈처럼 느껴집니다!)
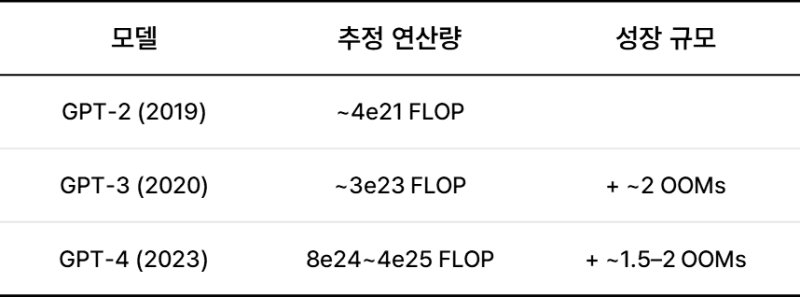
표 : GPT-2 ~ GPT-4에 대한 추정 연산랑 (by Epoch AI)
*~4e21 FLOP = 4 × 10²¹ = 4,000,000,000,000,000,000,000번의 연산
*~3e23 FLOP = 3 × 10²³ = 300,000,000,000,000,000,000,000번의 연산
*8e24~4e25 FLOP = 8×10²⁴ ~ 4×10²⁵ = 8,000,000,000,000,000,000,000,000번 ~ 40,000,000,000,000,000,000,000,000번
우리는 에포크 AI(Epoch AI, 인공지능 동향 분석으로 권위를 인정받는 기관)의 공개 추정치를 활용해 2019년부터 2023년까지의 연산 능력 확장을 추적할 수 있습니다.
GPT-2에서 GPT-3로의 발전은 급격한 확장이었습니다 : 작은 규모의 실험에서 전체 데이터센터를 동원해 대규모 언어 모델을 훈련시키는 수준으로 연산량이 폭증했습니다.
GPT-3에서 GPT-4로 넘어가며 우리는 새로운 패러다임에 진입했습니다 : 차세대 모델을 위해 완전히 새롭고 훨씬 더 큰 클러스터를 구축해야 하는 시대가 된 것입니다.
그럼에도 놀라운 성장은 계속되었죠. 종합적으로 에포크 AI는 GPT-4 훈련에 GPT-2 대비 약 3,000~10,000배 더 많은 원시 연산력이 사용된 것으로 추정합니다.
이는 오랜 기간 이어져 온 추세가 계속되는 것입니다. 지난 15년간 주로 투자 규모의 확대(GPU와 TPU 형태의 AI 전용 칩 개발 덕분)로 선도적 AI 시스템의 훈련 연산력은 매년 약 0.5 OOMs씩 성장했습니다.
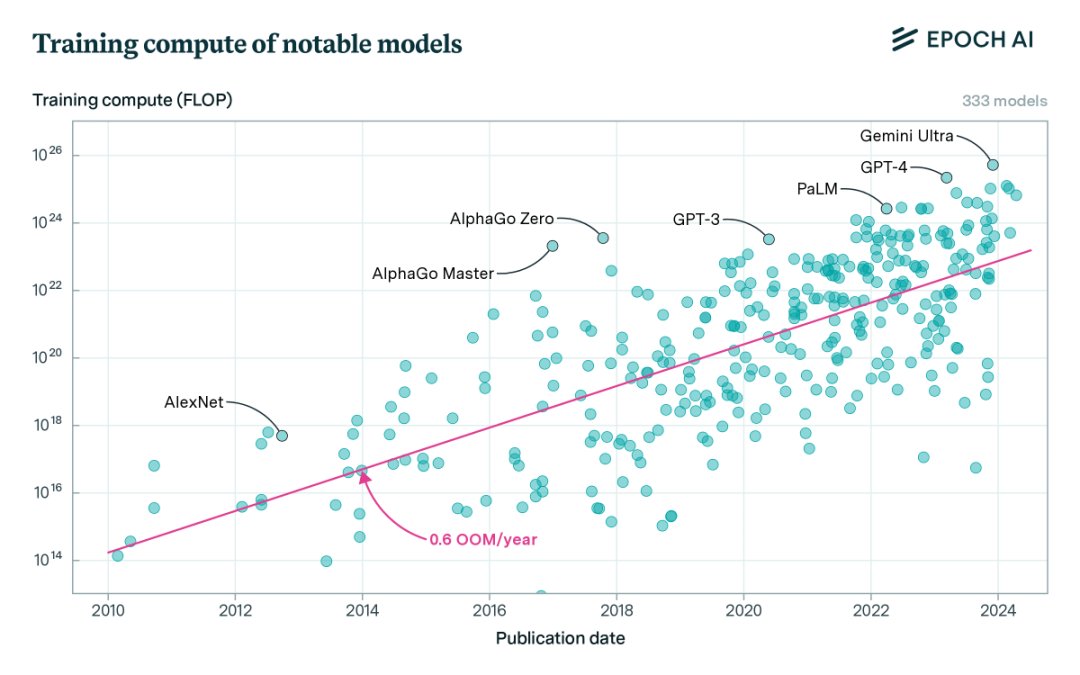
주요 딥러닝 모델의 훈련 연산력 추이. 출처: Epoch AI
GPT-2 → GPT-3의 1년 간 연산력 급증은 이례적이었지만, 모든 증거는 추세가 장기적으로 지속될 것임을 나타냅니다. 실리콘밸리의 복도통신은 엄청난 GPU 주문 소식으로 뜨겁습니다. 해당 분석에 따르면 2027년까지 추가 2 OOM(약 100억 달러)의 연산력 증가는 매우 가능성 높으며, 심지어 3 OOMs(1,000억 달러 이상)에 가까운 클러스터도 마이크로소프트/OpenAI에서 준비 중이라는 소문이 있습니다.
*미국 트럼프 대통령은 4년간 5,000억 달러(720조원) 규모의 스타게이트 프로젝트를 발표했으며, 즉시 1,000억 달러를 투자한다고 밝혔다. 오라클, Open AI, 소프트뱅크 등이 참여하는 민간 프로젝트이다.

인공지능 발전의 원동력 분석