0
 2025-05-02 12:41:51
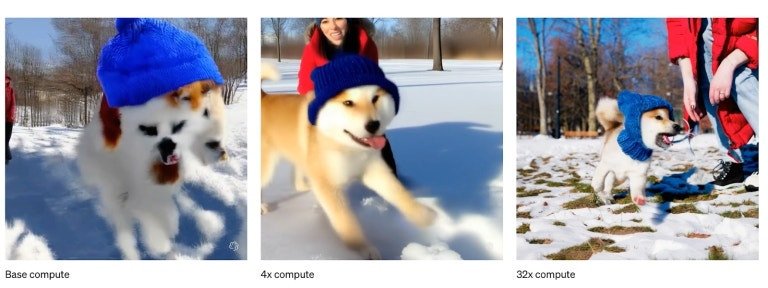
유효 연산력(effective compute)이 1 OOM 증가할 때마다 모델 성능은 예측 가능하게 향상됩니다. OOM을 계산하면 대략적으로 능력 향상을 추정할 수 있습니다. 이렇게 몇몇 선구자들은 GPT-4의 출현을 예측했죠.
GPT-2에서 GPT-4까지 4년 간의 발전을 세 가지로 나누어 살펴볼 수 있습니다.
연산력(or 컴퓨팅)(Compute) : 모델 훈련에 훨씬 더 큰 컴퓨팅 자원 사용.
알고리즘 효율성(Algorithmic efficiencies) : 지속적인 알고리즘 개선. 연산량을 증폭(compute multipliers)시키는 지속적인 기술 발전.
언호블링 이득(”Unhobbling” gains, 제약 해제) : 모델은 기본적으로 뛰어난 원시 능력을 학습하지만, 다양한 제약으로 실제 활용 가치가 제한됩니다. 인간 피드백 강화 학습(RLHF), 생각의 사슬(CoT), 도구 활용 등의 간단한 알고리즘 개선으로 잠재 능력을 해제할 수 있습니다.
*RLHF = Reinforcement Learning from Human Feedback = 인간 피드백 강화 학습
*CoT = Chain-of-Thought = 생각의 사슬 or 연쇄적 사고
우리는 이런 측면에서 개선을 OOM 단위로 계산할 수 있습니다. 각 분야의 성장 규모를 효과적 연산 단위로 추적하는 방식입니다. 3배 향상은 0.5 OOM, 10배는 1 OOM, 30배는 1.5 OOM, 100배는 2 OOM으로 계산됩니다. 2023년부터 2027년까지 GPT-4를 넘어서 어떤 발전을 기대할 수 있는지도 살펴볼 수 있습니다.
*1 OOM = 10배 성장 / 2 OOMs = 100배 성장 / 3 OOMs = 1,000배 성장 / 4 OOMs = 10,000배 성장 / 5 OOMs = 100,000배 성장 (역자 주)
각 항목을 하나씩 살펴보겠지만 결론은 명확합니다. 우리는 OOM 단계를 초고속으로 통과하고 있습니다. 데이터 장벽(data wall) 같은 장애물도 있지만, 전체적으로 2027년까지 GPT-4 수준을 또 한 번 뛰어넘는 발전이 예상됩니다. GPT-2에서 GPT-4로 도약했던 규모에 버금가는 발전이요.
*데이터 장벽 = data wall : 인공지능 개발에 필요한 양질의 데이터가 부족해지면서 데이터 확보 경쟁이 심화되는 현상. (역자 주)